Les IA génératives comme ChatGPT, Gemini ou Claude peuvent contenir des informations te concernant lorsque celles-ci étaient publiques sur le web au moment de leur entraînement. Elles n’ont pas de « fiche » sur toi : ce sont des modèles statistiques qui ont appris à partir de milliards de pages. Si ton nom, ton métier ou tes coordonnées circulaient en ligne, annuaires, articles, réseaux sociaux, courtiers en données, ils ont pu être absorbés dans les données d’entraînement, puis être restitués dans une réponse.
Bonne nouvelle : tu disposes de droits sous le RGPD, et tu peux réduire ton exposition en agissant à la source, là où les IA puisent leur matière. Ce guide explique d’où viennent tes données dans les IA, ce que dit la loi en France/UE, et comment limiter concrètement les risques.
En bref
- Les IA n’ont pas de base « profil » sur toi, mais peuvent restituer des infos publiques apprises pendant l’entraînement.
- La source principale, c’est le web public : annuaires, articles, réseaux, courtiers en données.
- Le RGPD s’applique : droit d’accès, de rectification et d’effacement valent aussi face aux fournisseurs d’IA établis ou actifs dans l’UE.
- Le levier le plus efficace : réduire ce qui est public à la source, pour limiter ce que les futures IA pourront apprendre.
D’où les IA tirent-elles tes données ?
Trois canaux principaux :
- Données d’entraînement (le plus important). Les grands modèles sont entraînés sur d’immenses corpus issus du web public. Si une page te mentionnait, elle a pu être incluse. C’est pourquoi un modèle peut « connaître » une personne publiquement visible sans qu’elle ait jamais rien fourni.
- Tes propres conversations. Ce que tu tapes dans une IA peut, selon le service et tes réglages, être conservé ou utilisé pour améliorer le produit. Évite d’y coller des données sensibles, et vérifie les options de confidentialité.
- La navigation web en temps réel. Certaines IA peuvent consulter le web au moment de répondre. Elles relisent alors les pages encore en ligne sur ton nom, d’où l’importance de nettoyer la source.
Le point commun de ces trois canaux : le web public. Moins tes données traînent en ligne, moins une IA, présente ou future, peut les apprendre ou les relire. Pour comprendre l’ampleur, regarde combien de sites te mentionnent réellement avec une analyse gratuite.
Que dit le RGPD sur l’IA et tes données ?
Le RGPD ne disparaît pas parce qu’une donnée passe par une IA (voir aussi les ressources CNIL sur l’IA). Si un fournisseur traite des données personnelles de résidents de l’UE, il est en principe soumis aux mêmes obligations qu’un autre responsable de traitement. Concrètement, tu peux invoquer :
- Le droit d’accès : demander quelles données te concernant sont traitées.
- Le droit de rectification : corriger une information inexacte (les IA peuvent inventer des faits, on parle d’« hallucinations »).
- Le droit à l’effacement : demander la suppression de données te concernant, selon l’article 17 du RGPD.
En pratique, faire « désapprendre » une donnée précise à un grand modèle est techniquement complexe : c’est un domaine encore mouvant. C’est pourquoi la stratégie la plus efficace reste préventive : réduire ce qui est public, pour limiter ce que les modèles peuvent ingérer. Pour le cadre général, voir le RGPD expliqué simplement.
À retenir : corriger une « hallucination » est un droit, mais agir en amont sur le web public est souvent plus efficace que d’espérer faire « oublier » un modèle déjà entraîné.
Les vrais risques pour ta vie privée
- Restitution d’infos personnelles : une IA peut afficher ton métier, ta ville, des éléments de profil… parfois mélangés avec ceux d’un homonyme (voir homonymes et vie numérique).
- Informations fausses : une IA peut générer des affirmations inexactes te concernant, avec un ton assuré. Difficile à corriger une fois diffusé.
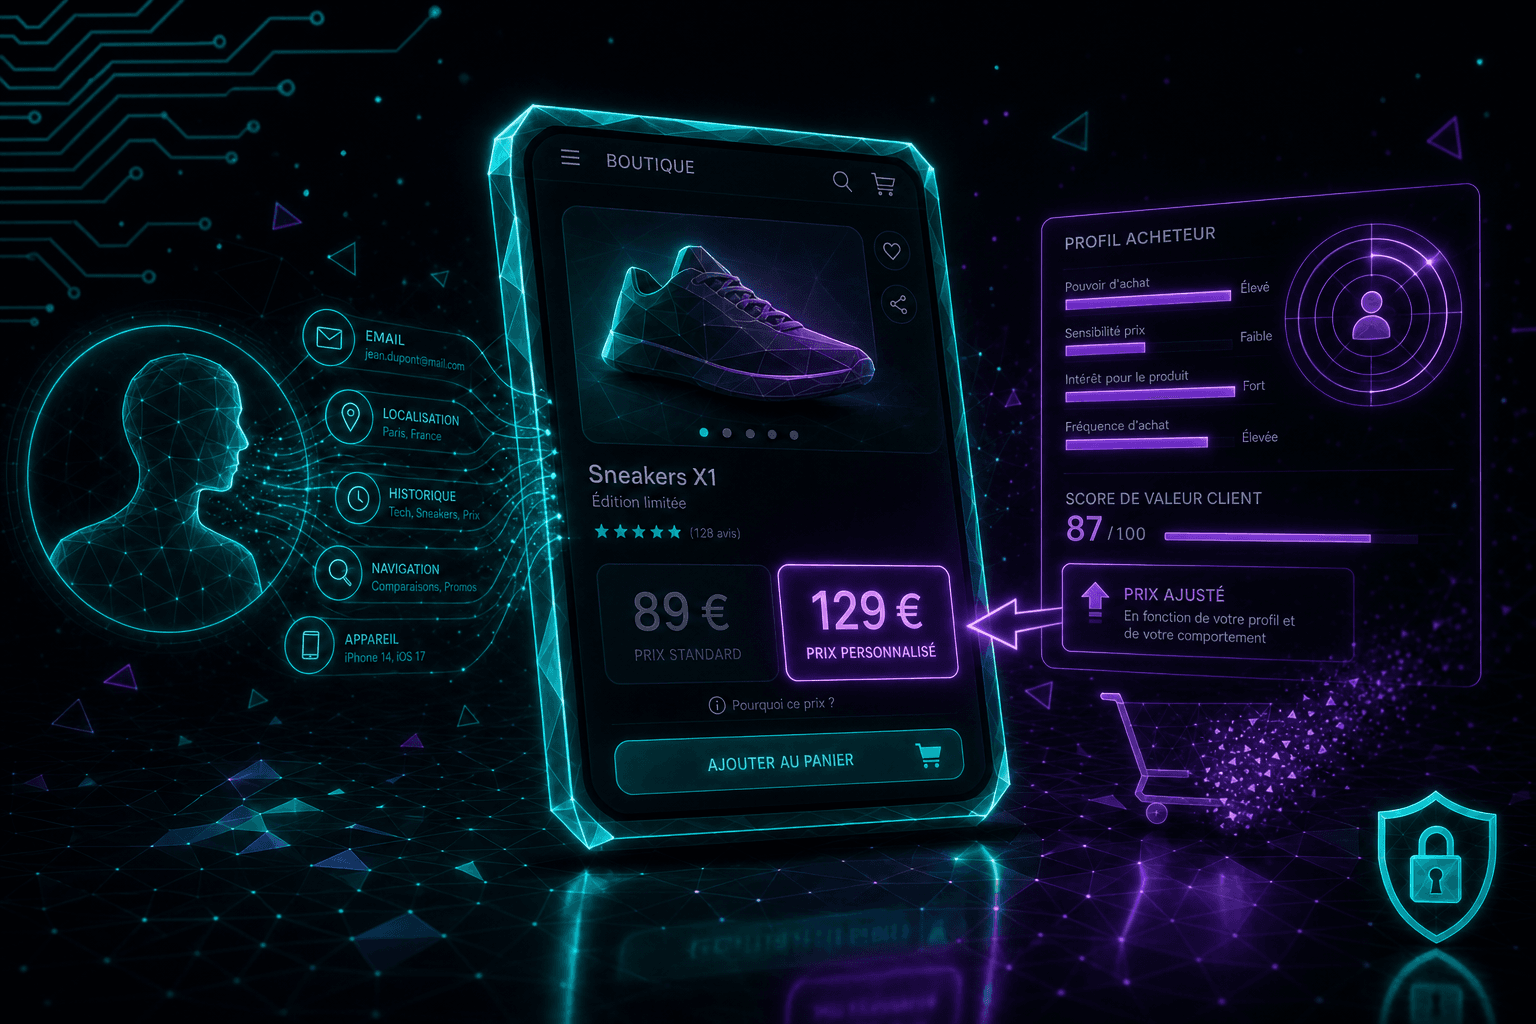
- Agrégation : croisée avec des courtiers en données, une IA peut faciliter le profilage. Le socle du problème reste l’écosystème des courtiers en données.
- Fuites de saisie : coller un document confidentiel dans un chat peut l’exposer selon le service. En cas de mot de passe concerné, voir mot de passe fuité : que faire en 5 minutes.
Comment limiter ton exposition aux IA
La logique : moins de données publiques = moins de matière pour les IA. Les actions concrètes :
- Mesure ton empreinte. Tu ne peux pas protéger ce que tu ne vois pas. Commence par une analyse gratuite pour cartographier où tu apparais (web public, courtiers, fuites).
- Efface à la source. Demande l’effacement RGPD aux annuaires, sites people search et courtiers qui exposent tes infos, c’est ce qui réduit la matière réutilisable. Voir retirer ses données des sites people search.
- Nettoie les résultats Google. Retrait de contenu personnel et déréférencement limitent ce qu’une IA peut relire en navigation : voir supprimer son nom des résultats Google.
- Verrouille tes réglages IA. Désactive, quand c’est possible, l’utilisation de tes conversations pour l’entraînement, et ne colle jamais de données sensibles dans un chat.
- Mets en place une veille. De nouvelles sources et de nouveaux modèles apparaissent en continu : un nettoyage récurrent vaut mieux qu’un nettoyage ponctuel.
C’est exactement la promesse de notre méthode : détecter les sources, envoyer des demandes d’effacement fondées sur le RGPD, et relancer jusqu’au retrait, pour réduire durablement ce que les IA peuvent apprendre de toi.
Voir aussi : Droits vie privée et données personnelles expliqués · Effacer ses traces sur internet · Supprimer son nom des résultats Google · Revente de données : qui les achète